
Ich starte mit einem Video von meinem Kollegen Naomi. Schau es dir an, um den ganzen Ansatz in Aktion zu sehen: von einer Idee bis zum gesteuerten KI-Workflow in einem fiktiven Unternehmen mit 500 Mitarbeitenden.
Okay, aber warum mit dem Fundament anfangen?
Die Zahlen zeigen es. Der Cost of a Data Breach Report 2025 von IBM hat 600 betroffene Organisationen untersucht und dabei zum ersten Mal auch KI-Sicherheit betrachtet. Das Ergebnis: 13 % hatten Sicherheitsvorfälle bei KI-Modellen oder -Anwendungen erlebt, und 97 % dieser Organisationen hatten keinerlei Zugriffskontrollen für KI. Bei den KI-bezogenen Vorfällen wurden in 60 % der Fälle Daten kompromittiert, in 31 % der Betrieb gestört.
Bei gescheiterten Projekten sieht es ähnlich aus. Im Januar 2026 stellte Gartner fest, dass mindestens die Hälfte aller GenAI-Projekte nach dem Proof of Concept abgebrochen wurde. Als Gründe nannte Gartner schlechte Datenqualität, unzureichende Risikokontrollen, steigende Kosten und unklaren Geschäftsnutzen.
Diese zweite Liste ist die spannende. Schwache Kontrollen und unklarer Nutzen treten gemeinsam auf. Ein sicheres Fundament gehört also dazu, wenn KI wirklich nützen soll. Es ist keine Nebenaufgabe für die Compliance-Abteilung.
Souveränität: drei Fragen statt einer
„Souveräne KI" wird gern locker verwendet. Hilfreicher ist es, den Begriff in drei getrennte Fragen aufzuteilen.
Die erste Frage lautet: Wo werden deine Daten verarbeitet? Das betrifft mehr als gespeicherte Dateien. Dazu gehören auch die Modell-Inferenz, Logs, Backups und die Vektorindizes, die das System aus deinen Dokumenten aufbaut.
Die zweite Frage lautet: Welches Recht gilt? Der Standort allein beantwortet das nicht. Im Juni 2025 fragte der französische Senat Anton Carniaux, Director of Public and Legal Affairs bei Microsoft France, ob er unter Eid garantieren könne, dass Daten französischer Bürger nie ohne französische Zustimmung an US-Behörden gehen. Seine Antwort: „Nein, das kann ich nicht garantieren, aber es ist, wie gesagt, noch nie passiert." In derselben Anhörung sagte Microsoft, dass europäische Kundendaten seit Januar 2025 vertraglich garantiert innerhalb der EU bleiben. Diese Garantie beruht auf Microsofts EU Data Boundary. Beide Aussagen stimmen, und genau das ist der Punkt. Der US CLOUD Act erlaubt es US-Behörden, US-Unternehmen zur Herausgabe von Daten zu zwingen, egal wo sie gespeichert sind. Ein EU-Rechenzentrum sagt dir, wo deine Daten liegen. Es sagt dir nicht, wer sie rechtmäßig verlangen kann.
Die dritte Frage lautet: Wer kontrolliert den Betrieb? Kannst du wählen, wo die Plattform läuft? Kannst du Modelle wechseln, deine Daten mitnehmen und weiterarbeiten, wenn ein Anbieter seine Bedingungen ändert?
Buyers beschäftigen sich schon mit diesen Fragen. Die Studie State of AI 2026 von Deloitte zeigt, dass 77 % der Unternehmen bei der Wahl von KI-Anbietern inzwischen das Herkunftsland des Anbieters berücksichtigen. IONOS ist eines der strengsten Beispiele. Das Unternehmen verkauft europäische Cloud-Infrastruktur als Alternative zu den Hyperscalern und hat deshalb seine eigenen internen KI-Tools am Standard für digitale Souveränität gemessen, den es Kunden gegenüber vertritt.
Was das in der Praxis bedeutet
Eine Plattform sollte dich die Infrastruktur nach Rechtsraum wählen lassen, nicht nur nach Region. Für die meisten Organisationen heißt das: europäisches Cloud-Hosting, idealerweise bei einem Anbieter, der europäischem Recht unterliegt. Für regulierte Branchen und sehr große Organisationen heißt es: Betrieb in der eigenen Cloud oder On-Premises. Admins sollten außerdem festlegen können, welche Modelle welche Daten verarbeiten dürfen, damit besonders sensible Inhalte nur an Modelle gehen, die die Anforderungen erfüllen. Und der Anbieter sollte klar zusagen, dass deine Daten nie zum Training seiner Modelle verwendet werden.
Sicherheit: Was sich ändert, wenn ein System alles lesen kann
Eine KI-Plattform ist keine gewöhnliche Software. Sie ist dafür gebaut, über deine Systeme hinweg zu lesen, und genau diese Reichweite macht sie wertvoll und riskant zugleich.
Die OWASP Top 10 für LLM-Anwendungen führen Prompt Injection auf Platz eins und beschreiben sie als weitgehend ungelöst, weil Sprachmodelle Anweisungen und Daten über denselben Kanal aufnehmen. In der Ausgabe 2025 sprang die Offenlegung sensibler Informationen von Platz sechs auf Platz zwei. Neu hinzu kam eine Kategorie für Schwachstellen bei Vektoren und Embeddings. Sie betrifft die Retrieval-Systeme, die KI-Antworten in Unternehmensdaten verankern.
Prompt Injection lässt sich nicht einfach wegpatchen. Die Abwehr muss deshalb in der Architektur stecken. In der Praxis läuft das auf fünf Dinge hinaus.
Berechtigungen. Wenn ein Mitarbeitender eine Datei in SharePoint nicht öffnen darf, darf die KI sie ihm auch nicht zitieren. Die Plattform muss das beim Abruf technisch durchsetzen. Das Modell zu bitten, sich zu benehmen, zählt nicht als Durchsetzung.
Identität. Single Sign-on, automatisches Anlegen und Entfernen von Accounts und klare Rollen dafür, wer bauen, teilen und administrieren darf.
Grenzen für Agenten. Jeder Agent sollte nur die Tools bekommen, die seine Aufgabe braucht. Bevor er etwas versendet, löscht oder Wichtiges ändert, sollte ein Mensch zustimmen.
Nachvollziehbarkeit. Wer einen Vorfall untersucht, muss sehen können, wer was gefragt hat, welche Quellen das System genutzt hat und welche Aktionen ein Agent ausgeführt hat. Ohne diese Protokolle bleibt die Untersuchung Rätselraten.
Isolation und unabhängige Audits. Kunden sollten strikt voneinander getrennt sein, generierter Code sollte in einer Sandbox laufen, und Zertifizierungen wie ISO/IEC 27001, SOC 2 Type II oder BSI C5 sollten von externen Prüfern stammen. Ein Zertifikat beweist nicht, dass ein System sicher ist. Es beweist, dass ein Auditor geprüft hat, ob ein Sicherheitsmanagementsystem existiert und funktioniert.
Shadow AI ist ein Produktproblem
IBM hat festgestellt, dass jede fünfte Organisation einen Vorfall im Zusammenhang mit Shadow AI hatte, also mit Tools, die Mitarbeitende ohne Freigabe nutzen. Organisationen mit viel Shadow AI zahlten pro Vorfall im Schnitt 670.000 US-Dollar mehr als solche mit wenig oder gar keiner. Bei Vorfällen mit Shadow AI waren in 65 % der Fälle personenbezogene Daten betroffen, über alle Vorfälle hinweg waren es 53 %.
Menschen greifen nicht aus Trotz zu nicht freigegebenen Tools. Sie tun es, weil das freigegebene Tool ihnen nicht hilft, ihre Arbeit zu erledigen. In einer Umfrage von Cybernews unter mehr als 1.000 Beschäftigten in den USA sagten nur 33 %, dass die freigegebenen KI-Tools ihres Unternehmens ihre Anforderungen vollständig erfüllen. Eine Richtlinie kann das Verhalten verbieten, aber sie kann den Leuten nichts Besseres in die Hand geben. Sicherheit hängt also auch von Nützlichkeit ab. Der Rest dieses Artikels zeigt, was eine Plattform nützlich genug macht, damit Menschen sie freiwillig wählen.
Vom Fundament zum Betriebssystem
Ein Chatfenster auf einer sicheren Cloud ist ein guter Anfang, aber es verändert nicht, wie ein Unternehmen arbeitet. Ein AI Operating System verbindet die Teile, die sonst getrennt nebeneinander liegen: Unternehmenswissen, Modelle, Agenten, automatisierte Prozesse, interne Tools und die Regeln, die für all das gelten. Jede Fähigkeit greift auf denselben Kontext zu und hält dieselben Berechtigungen ein. Was ein Team baut, steht deshalb auch dem nächsten zur Verfügung.
Die folgenden Abschnitte gehen die wichtigsten Fähigkeiten durch, mit nuwacom als Praxisbeispiel und mit den Grenzen direkt neben den Stärken.
Context Engine: Antworten aus deinem eigenen Wissen, mit Quellen
Modelle kennen das öffentliche Internet. Deine Verträge kennen sie nicht, deine Prozesse auch nicht, und was dein Team im letzten Quartal entschieden hat, erst recht nicht. Die Context Engine schließt diese Lücke. Sie bindet Unternehmenswissen über mehr als 100 Konnektoren an, darunter SharePoint, Google Drive, Confluence, Salesforce, SAP, ServiceNow und Jira, und antwortet mit Quellenangaben. Statt Inhalte nur dann zu holen, wenn jemand fragt, pflegt sie einen dauerhaften Index über alle angebundenen Systeme. So steht Retrieval für Chats, Agenten, Workflows, Suche und Apps jederzeit und gleichzeitig zur Verfügung.
Die Verankerung in eigenen Quellen reduziert Fehler, beseitigt sie aber nicht. Stanford RegLab und HAI haben eine präregistrierte Studie durchgeführt, die später im Journal of Empirical Legal Studies begutachtet wurde, und darin spezialisierte juristische Recherche-Tools untersucht. Lexis+ AI lieferte bei mehr als 17 % der Anfragen falsche Informationen, das KI-Recherche-Tool von Westlaw bei mehr als 34 %, obwohl beide mit Retrieval arbeiten. Die Forschenden folgerten: „Die Aussagen der Anbieter sind überzogen." Genau deshalb sind Quellenangaben wichtig: Sie machen das Prüfen schnell. Eine weitere Warnung gilt für jede Plattform dieser Kategorie: Berechtigungsbewusstes Retrieval macht sichtbar, was deine Quellsysteme ohnehin zu großzügig freigeben. Prüfe deshalb deine SharePoint-Berechtigungen, bevor du irgendetwas anbindest.
Ein Legal-Team findet damit relevante Klauseln und Präzedenzfälle in allen angebundenen Systemen mit einer einzigen Suche. Ein Support-Team beantwortet Produktfragen aus der aktuellen Dokumentation statt aus dem Wiki vom letzten Jahr.
Gemeinsames Gedächtnis und der Notetaker
Der MIT-NANDA-Report The GenAI Divide stützte sich auf mehr als 300 öffentliche KI-Initiativen, 52 Interviews und 153 Umfrageantworten. Die oft zitierte Schlagzeile lautete, 95 % der Organisationen hätten keinen messbaren Gewinneffekt gesehen. Diese Zahl ist keine peer-reviewte Fehlerquote und sollte auch nicht als solche dargestellt werden. Die engere Schlussfolgerung hält besser: Viele Piloten waren nie mit einem gemessenen Ergebnis verbunden, nie mit einem produktiven Workflow, nie mit verlässlichem Unternehmenskontext und nie mit einer Möglichkeit, aus der Nutzung zu lernen.
nuwacom behandelt Gedächtnis als Unternehmenswert. Die Context Engine speichert Entscheidungen, Meeting-Ergebnisse, Projektdetails und Workflow-Resultate und macht sie über Personen, Agenten und Apps hinweg verfügbar. Der Notetaker speist dieses Gedächtnis direkt. Er begleitet virtuelle Meetings bis zu zwei Stunden und Präsenzmeetings ohne Längenbegrenzung. Transkript, Zusammenfassung, Entscheidungen und Aufgaben landen in der gemeinsamen Wissensbasis statt im Chatverlauf einer einzelnen Person. Wer als Projektleitung mitten im Quartal einsteigt, kann fragen, was das Team im Mai zum Pricing entschieden hat, und bekommt die Antwort mit einem Link zum Meeting, aus dem sie stammt.
Model Hub: mehrere Anbieter, ein Regelwerk
Kein einzelnes Modell ist bei jeder Aufgabe das beste, und die Rankings ändern sich alle paar Monate. Der Model Hub bringt OpenAI, Gemini, Claude, Mistral und in Europa gehostete Open-Weight-Modelle in einer gesteuerten Umgebung zusammen. Modellfreigaben lassen sich pro Team steuern. Ein Legal-Team kann sensible Arbeit auf die Modelle beschränken, die seine Richtlinie erlaubt, während das Marketing das Modell nutzt, das für eine Kampagne am besten schreibt.
Ein Modellwechsel läuft nie ganz reibungslos, weil Modelle auf dieselben Prompts und Tools unterschiedlich reagieren. Dazu gibt es eine konkrete Grenze: nuwacom bietet derzeit weder Bring Your Own Key noch eine einheitliche API, um externe Modelle einzubinden. Das Prinzip bleibt trotzdem gültig. Je mehr du in Kontext und Workflows investierst, desto mehr sollte diese Investition unabhängig von einem einzelnen Anbieter bleiben. IONOS nannte das als entscheidenden Faktor. Das Unternehmen wollte das Ergebnis, das am besten zur jeweiligen Aufgabe passt, und keine Loyalität gegenüber einem Modell.
Agenten und Skills: wiederholbare Arbeit mit klaren Grenzen
Sobald KI Aktionen ausführt, wachsen Nutzen und Risiko gleichermaßen. OWASP hat 2025 aus genau diesem Grund „Excessive Agency" in seine Liste aufgenommen. Ein brauchbarer Agent braucht einen definierten Auslöser, Zugriff nur auf bestimmte Tools, Freigabeschritte dort, wo viel auf dem Spiel steht, Fehlerbehandlung und Logs.
In nuwacom bauen Teams Agenten aus Vorlagen, über einen geführten Use-Case-Finder oder durch manuelle Konfiguration. Agent Actions, noch in der Beta, verbinden sich mit Slack, Microsoft Teams, Gmail, Google Calendar, Google Drive, SharePoint und OneDrive. Skills ergänzen die Agenten als wiederverwendbare Bausteine: eine definierte Art, eine bestimmte Aufgabe zu erledigen, die Agenten, Workflows und Apps gleichermaßen aufrufen können. Ein Marketing-Team könnte sein Briefing-Format einmal als Skill hinterlegen und dann jeden Kampagnen-Agenten darauf zugreifen lassen. Ein Sales-Team könnte einen Agenten für Prospect-Recherche einsetzen, der vor jedem Erstgespräch CRM und Websuche auswertet.
Workflows: Prozesse, die mit Menschen im Loop laufen
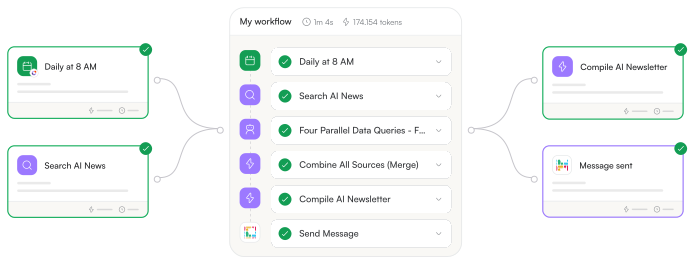
Workflows verketten Agenten, externe Integrationen und automatisierte Trigger zu wiederholbaren Prozessen, mit menschlichen Freigabeschritten, wo sie nötig sind. Ein Agent kann sein Ergebnis an den nächsten weitergeben, sodass spezialisierte Agenten eine komplexe Aufgabe untereinander aufteilen. Workflows können ereignisgesteuert oder nach Zeitplan laufen.
Der Rollout bei IONOS zeigt, wie das in der Praxis aussieht. Das Kommunikationsteam erstellte in einer Stunde Arbeitszeit mehr als 30 einzelne Inhalte, eine Arbeit, die früher mehrere Tage dauerte. Jeder Inhalt wurde trotzdem von der zuständigen PR-Expertin oder dem zuständigen PR-Experten geprüft, bevor er rausging. Das System erledigte die Vorarbeit, und Menschen trafen die Entscheidung.
Apps, die Ihre Teams selbst bauen
Jede Abteilung bastelt sich irgendwann eigene Tracker, Dashboards und Prozess-Tools, weil nichts von der Stange gut genug passt. Wenn diese Tools in privaten Tabellen oder nicht freigegebenen Apps leben, werden sie zum nächsten Shadow-IT-Problem.
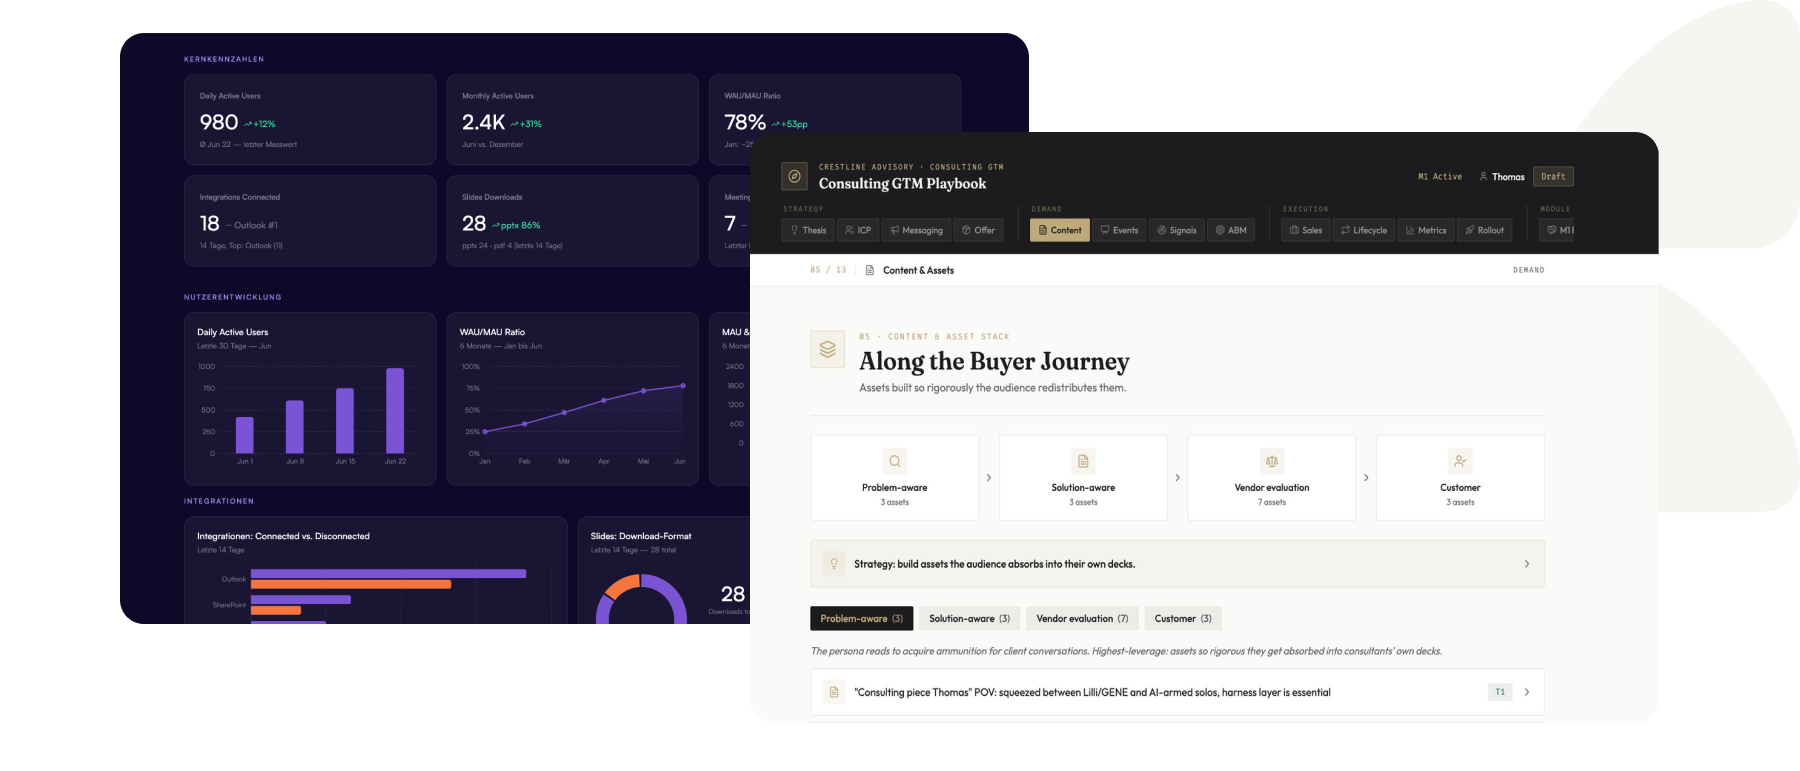
nuwacom Apps macht aus dieser Bastelei kontrollierte Software. Ein Team beschreibt in einfacher Sprache, welches Tool es braucht. nuwacom schreibt den Code, validiert ihn und führt ihn in einer isolierten Sandbox innerhalb der Plattform aus, ganz ohne Repository, Pipeline oder separates Hosting. Apps übernehmen die Workspace-Berechtigungen, lesen aus der Wissensbasis, rufen Skills auf und nutzen Konnektoren. Eine eigene Datenbank außerhalb der gesteuerten Umgebung entsteht dabei nicht. Der Orchestrator geht noch einen Schritt weiter und kann über dieselbe Funktion selbst Apps bauen.
Die dokumentierten Beispiele sind praxisnah: ein Live-Dashboard für das Management, das Kennzahlen aus mehreren internen Quellen zieht, eine App zur Vorbereitung von Sales-Meetings, die E-Mails, CRM-Datensätze und Meeting-Notizen bündelt, und eine Onboarding-Akademie mit Quiz und Abschluss-Tracking. Das Finance-Team kann aus einer vorhandenen Datendatei eine interaktive Ansicht machen, ohne eine Zeile Code und ohne IT-Ticket.
AI Guardrails: konsistente Ergebnisse im ganzen Unternehmen
Brand-Voice- und Content-Regeln leben meistens in einem PDF, das niemand öffnet. AI Guardrails machen sie wirksam: Brand-Voice-Regeln, verbotene Begriffe, Stilbeispiele und Tonvorgaben, die auf Workspace-, Projekt- oder Prompt-Ebene gelten. Ein regionales Marketing-Team bekommt dieselben Formulierungsstandards wie die Zentrale, ohne dass jemand jeden Entwurf kontrollieren muss.
Governance und das zentrale KI-Budget
Vier Rollen steuern, wer bauen, teilen und administrieren darf: Super Admin, Admin, Editor und Viewer. SSO und User Sync funktionieren mit Active Directory, Okta und Entra ID. Mit einem zentralen KI-Budget verteilen Admins die Nutzung auf Nutzende, Teams, Agenten, Workflows und externe Chatbots. Das ist wichtig, sobald Automatisierung mehr verbraucht als Menschen: Ausgaben für Agenten und für Menschen liegen dann in einem gemeinsamen, gesteuerten Topf mit derselben Transparenz.
So sieht das im ganzen Unternehmen aus
Zusammengenommen verändern diese Fähigkeiten die Einheit der Arbeit. Der Vertrieb bereitet sich mit einer App auf Gespräche vor, die die Historie des Accounts schon kennt. HR baut aus vorhandenen Dokumenten in Stunden eine Onboarding-Akademie, statt ein Softwareprojekt zu beauftragen. Das Marketing produziert Kampagnen schneller, weil Skills und Guardrails die Markenregeln mitbringen. Legal sucht an einem Ort statt an fünf. Die Geschäftsleitung liest ein Dashboard, das sich aus den führenden Systemen aktualisiert, statt auf die monatliche Foliensammlung zu warten.
Nichts davon macht Implementierung, Training, Use-Case-Auswahl und Erfolgsmessung überflüssig. Die richtige Kennzahl ist nicht, wie viele Prompts Mitarbeitende abschicken. Entscheidend ist, welcher Prozess schneller, konsistenter oder besser prüfbar geworden ist.
Governance, die du nachweisen kannst
Der Zeitplan des EU AI Act hat sich 2026 geändert, die Pflichten bleiben aber bestehen. Die Verordnung (EU) 2026/1744, der Digital Omnibus on AI, ist am 27. Juli 2026 in Kraft getreten. Sie hat die Pflichten für eigenständige Hochrisiko-Systeme nach Anhang III auf den 2. Dezember 2027 verschoben und die Pflichten für KI in regulierten Produkten nach Anhang I auf den 2. August 2028. Die Transparenzregeln nach Artikel 50 gelten weiterhin ab dem 2. August 2026. Die Pflicht zur KI-Kompetenz nach Artikel 4 gilt seit dem 2. Februar 2025, der Omnibus hat ihren Wortlaut angepasst.
In der Praxis sollte eine Plattform dir helfen, ein Inventar zu führen: Welche Modelle, Agenten und Apps sind im Einsatz, und wer nutzt sie? Sie sollte die Nutzung protokollieren, die Kennzeichnung KI-generierter Inhalte unterstützen und Admins Kontrolle über Zugriff und Ausgaben geben. Nichts davon ist Rechtsberatung. Lass deine eigenen Use Cases von qualifizierten Juristinnen und Juristen bewerten.
Zehn Fragen, die du jedem Anbieter stellen solltest
Wo werden meine Daten gespeichert und verarbeitet, einschließlich Logs, Backups und Suchindizes?
Welches Landesrecht gilt für euch und für euren Infrastrukturanbieter?
Welche Betriebsmodelle bietet ihr an, von der europäischen Cloud bis zu meiner eigenen Infrastruktur?
Werden meine Daten jemals zum Training von Modellen verwendet?
Setzt das Retrieval die Berechtigungen des ursprünglichen Quellsystems durch?
Was darf ein Agent ohne menschliche Freigabe tun?
Kann ich die Quellen hinter jeder Antwort sehen?
Kann ich einschränken, welche Modelle welche Daten sehen?
Welche Zertifizierungen und rechtlichen Zusatzvereinbarungen bietet ihr an, auch für DORA und das Berufsgeheimnis nach § 203 StGB?
Was passiert mit meinem Wissen, meinen Workflows und meinen Apps, wenn ich das Modell wechsle oder gehe?
Ein guter Anbieter begrüßt solche Fragen. Prüfen Sie die Antworten an einem Workflow, den Sie tatsächlich betreiben, und schauen Sie, welche Belege zurückkommen.